Modelos de decisão: como funcionam, quando usar e como combinar com RAG
Imagine um sistema de atendimento que recebe esta mensagem: “Paguei o boleto ontem, mas meu serviço continua bloqueado”.
Antes de escrever qualquer resposta, o sistema precisa identificar o assunto e encaminhar a solicitação. As opções podem ser financeiro, suporte técnico, vendas ou outros.
Um modelo de linguagem (LLM) consegue fazer essa classificação. Porém, quando a tarefa se repete milhares de vezes, vale perguntar: precisamos usar o mesmo processo de geração de texto empregado para escrever artigos, explicar conceitos ou produzir código?
Os modelos de decisão atendem justamente a essa necessidade. Eles avaliam perguntas delimitadas e devolvem resultados que um programa consegue utilizar diretamente. Nesse tipo de tarefa, podem oferecer respostas rápidas e custos bem inferiores aos de chamadas a modelos generativos convencionais.
Também podem participar de sistemas com RAG, ajudando a selecionar as informações que serão usadas na resposta. Para entender essa combinação, precisamos primeiro separar três atividades:
- encontrar conteúdo;
- avaliar sua utilidade;
- escrever uma explicação.
O que são modelos de decisão?
São modelos preparados ou disponibilizados para avaliar condições e opções definidas pela aplicação.
Em vez de pedir “analise esta mensagem e escreva o que devemos fazer”, podemos formular perguntas específicas:
- O cliente está relatando um problema de pagamento?
- Qual departamento deve receber a mensagem?
- Qual é a urgência, segundo os critérios fornecidos?
O retorno pode incluir uma opção escolhida, uma pontuação e probabilidades. O programa recebe esses valores e aplica sua lógica.
Os três formatos mais comuns são:
| Formato | Exemplo | Resultado esperado |
|---|---|---|
| Sim ou não | O cliente pediu atendimento humano? | Probabilidade de a resposta ser “sim”. |
| Escolha | Qual setor deve atender? | Uma opção entre financeiro, suporte, vendas e outros. |
| Pontuação | Qual é a urgência deste chamado? | Uma nota segundo níveis previamente descritos. |
Essa organização aparece tanto no Jev quanto no Gemini Decision 1, embora os campos e recursos de cada produto variem.
O nome “modelo de decisão” pode sugerir que a IA assume todo o controle. Na prática, ela fornece uma avaliação. O código continua responsável por transformar esse resultado em uma ação, respeitando regras, permissões e condições do sistema.
Qual é a diferença para um LLM generativo?
Os grandes modelos de linguagem, conhecidos como LLMs, conseguem escrever, resumir, explicar e produzir código. Os modelos generativos mais comuns constroem a saída por meio da geração de tokens, pequenas unidades de texto.
Um caminho específico para decisões pode avaliar as alternativas e retornar valores diretamente, dispensando a geração de uma resposta escrita. É assim que o Google descreve o funcionamento do Gemini Decision 1.
A diferença prática fica mais clara nesta comparação:
| Necessidade | Modelo de decisão | LLM generativo |
|---|---|---|
| Escolher um setor entre opções conhecidas | Adequado para essa avaliação delimitada. | Também consegue classificar. |
| Avaliar um trecho por critérios fornecidos | Pode retornar uma probabilidade ou nota. | Pode avaliar e escrever uma análise. |
| Redigir uma resposta ao cliente | Não atende: retorna avaliações estruturadas, sem redigir respostas. | Adequado para gerar o texto. |
| Produzir uma explicação detalhada | Não atende: não gera uma explicação escrita para sua avaliação. | Pode gerar a explicação. |
| Executar muitas classificações pequenas | Pode reduzir custo e tempo. | O resultado depende do modelo e da configuração. |
Nesta comparação, “modelo de decisão” se refere ao uso específico para avaliações estruturadas. O GPT-6 Luna pode retornar avaliações estruturadas pela Decisions API ou gerar texto pelas APIs Responses e Chat Completions. Portanto, nesse caso, a limitação de saída está na interface utilizada, não na capacidade geral do modelo.
LLMs também oferecem saídas estruturadas, como JSON. Portanto, a diferença não se resume a “um devolve números e o outro devolve palavras”.
Jev, Gemini Decision 1 e outras alternativas
Existem diferentes ofertas nessa área. Quatro exemplos ajudam a compreender o cenário.
Jev, da TypeSafe AI
O Jev recebe contexto e perguntas estruturadas, devolvendo avaliações que o código pode utilizar para classificação, encaminhamento e pontuação.
A TypeSafe o apresenta como um modelo da categoria System One. Sua documentação recomenda perguntas pequenas, cada uma voltada a um aspecto específico, com os resultados combinados pelo programa. Além de escolha, pontuação e sim/não, a documentação atual inclui o tipo Box, para localização em imagens.
Gemini Decision 1, do Google
O Gemini Decision 1 é o modelo especializado acessado pela Gemini Decisions API. Aceita texto, imagens, áudio, vídeo e PDFs, retornando avaliações sem gerar tokens de texto na saída.
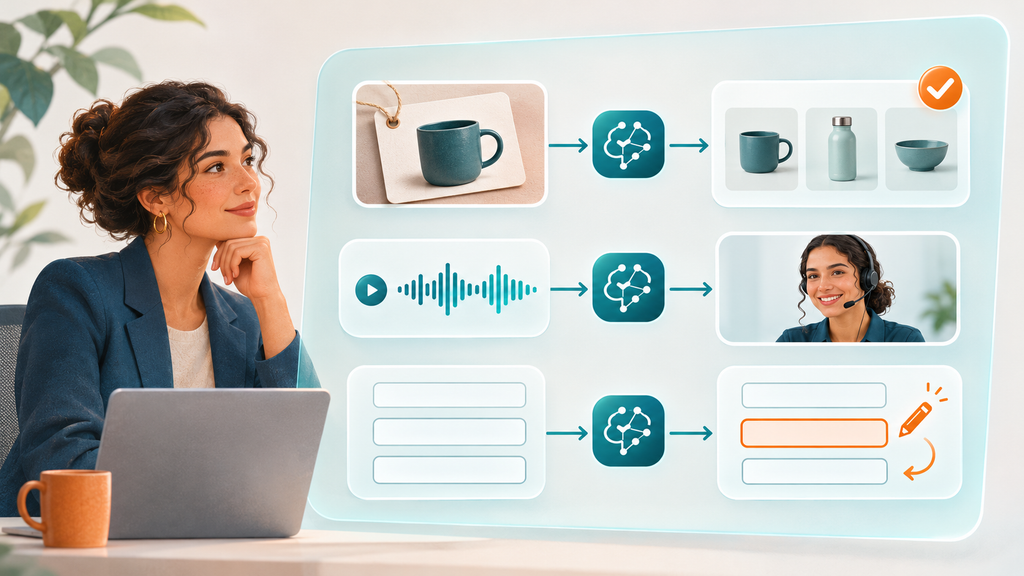
Isso permite, por exemplo, perguntar se uma imagem contém um comprovante ou se uma gravação inclui um pedido para falar com um atendente.
OpenAI Decisions API
A Decisions API da OpenAI utiliza o GPT-6 Luna para responder a perguntas delimitadas de sim/não, escolha e pontuação. Aceita texto, imagens e dados estruturados.
Aqui, é importante distinguir o nome da interface, Decisions API, do modelo utilizado por ela, GPT-6 Luna.
DiffusionGemma com projetos como dgem
O DiffusionGemma é um modelo experimental de pesos abertos capaz de gerar texto. Projetos como o dgem permitem utilizá-lo como motor de decisões, obtendo probabilidades para alternativas sem precisar gerar uma resposta livre.
Essa opção permite implantação em infraestrutura própria, mas exige configuração e recursos computacionais. Ter pesos abertos não elimina os custos de execução.
Além do texto: decisões sobre imagens, áudio e vídeo
Os modelos de decisão também podem avaliar informações visuais e sonoras. Essa capacidade é chamada de multimodalidade: trabalhar com diferentes tipos de entrada, como texto, imagem e áudio.
Isso amplia as aplicações. Um sistema pode avaliar uma foto enviada pelo cliente, identificar uma solicitação em uma gravação ou verificar se determinada situação aparece em um vídeo.
Os recursos variam conforme o modelo e a interface utilizada.
| Opção | Recursos que merecem destaque |
|---|---|
| Jev | Aceita texto e possui recursos experimentais para imagens. O tipo Box permite localizar um elemento na imagem, retornando as bordas de uma caixa ao redor dele. |
| Gemini Decision 1 | Aceita diretamente texto, imagens, áudio, vídeo e PDFs, inclusive combinando diferentes formatos na mesma entrada. |
| OpenAI Decisions API com GPT-6 Luna | Aceita texto, imagens e JSON. Pode participar de aplicações de voz por integração com outros componentes, mas o endpoint de decisões não recebe áudio diretamente. |
| DiffusionGemma com dgem | O dgem documenta decisões sobre texto e imagens, incluindo avaliação visual e localização aproximada de elementos. Os recursos disponíveis dependem da implementação. |
Por que os custos podem ser muito menores?
Em uma classificação curta, escrever uma explicação pode ser desnecessário. O sistema precisa apenas saber qual opção foi escolhida.
Um caminho específico para decisões pode economizar pelo preço de entrada, pela ausência de geração de texto e pelo modelo de cobrança. Nas APIs de decisões do Google e da OpenAI citadas aqui, não há cobrança por tokens de saída.
Veja alguns preços de referência consultados em 16 de novembro de 2026:
| Serviço | Preço de entrada por 1 milhão de tokens |
|---|---|
| Jev | US$ 0,042 |
| Gemini Decision 1 | US$ 0,10 |
| OpenAI Decisions API com GPT-6 Luna | US$ 0,10, para entrada sem cache |
| Gemini 3.5 Flash-Lite, generativo | US$ 0,30, mais US$ 2,50 por milhão de tokens de saída |
São valores de referência: condições de processamento, descontos e outras modalidades podem alterar a cobrança. No caso do Jev, o preço anunciado de US$ 42 por bilhão equivale a US$ 0,042 por milhão.
Um exemplo de custo para a mesma tarefa
Considere 100 mil classificações, cada uma com mil tokens totais de entrada. Para o modelo generativo, suponha também 20 tokens faturáveis de saída por classificação.
Com as tarifas padrão citadas, sem cache, descontos, ferramentas ou tokens adicionais:
| Alternativa | Entrada | Saída | Total estimado |
|---|---|---|---|
| Gemini Decision 1 | US$ 10 | US$ 0 | US$ 10 |
| Gemini 3.5 Flash-Lite | US$ 30 | US$ 5 | US$ 35 |
Nesse cenário ilustrativo, a redução seria de aproximadamente 71%. O preço do Flash-Lite inclui cobrança por saída e eventuais tokens de raciocínio.
Esse cálculo não é um teste de qualidade ou velocidade. Ele mantém as quantidades definidas para mostrar o efeito das tarifas. Na aplicação real, instruções, critérios e formatação alteram o consumo.
A comparação mais útil é o custo por tarefa resolvida corretamente, considerando também erros, novas tentativas e revisões.
Quando usar na prática
Uma boa oportunidade aparece quando a pergunta é delimitada, as opções são conhecidas e a avaliação se repete com frequência.
No atendimento, o modelo pode identificar o assunto de uma mensagem. Em uma automação, pode selecionar uma ferramenta entre alternativas autorizadas. Em uma base de conhecimento, pode avaliar se um trecho responde à pergunta.
Considere um assistente que dispõe de três ferramentas: consultar pedido, consultar pagamento e abrir chamado. O modelo identifica qual delas parece adequada. Antes de executá-la, o código verifica os dados necessários e a permissão do usuário.
A classificação não deve liberar ações por conta própria. Identificar um pedido de cancelamento, por exemplo, é diferente de autorizar e executar o cancelamento.
Também há tarefas que dispensam IA: comparar valores, verificar uma data de vencimento ou conferir uma permissão registrada no banco de dados. Nessas situações, regras de programação oferecem uma resposta direta.
Já a redação de uma orientação ou uma análise que exige várias etapas pode continuar com um LLM generativo.
Exemplos práticos
Não é necessário consultar uma base de documentos para aproveitar esses modelos. Muitas aplicações trabalham apenas com a mensagem, a imagem, a gravação ou o estado atual de um sistema.
1. Conferir fotos de produtos antes da publicação
Imagine uma loja virtual que recebe centenas de fotos enviadas por fornecedores. Antes de publicar, a equipe precisa verificar se cada imagem atende aos requisitos do catálogo.
Um modelo com entrada de imagem poderia avaliar perguntas específicas:
- O produto aparece inteiro?
- A imagem está desfocada a ponto de dificultar sua identificação?
- Existe uma marca d’água sobre o produto?
- O fundo atende ao padrão definido para o catálogo?
O sistema combina essas avaliações com verificações feitas por código, como resolução mínima e formato do arquivo.
Se a imagem atender aos critérios e às condições de aceitação testadas pela loja, poderá seguir para publicação. Se houver um problema claro, o fornecedor recebe uma mensagem padronizada solicitando outra foto. Casos incertos vão para revisão.
A vantagem prática é concentrar a atenção da equipe nas imagens que precisam de intervenção. O modelo avalia características visuais; o programa controla a publicação e as notificações.
2. Encaminhar uma solicitação recebida por áudio
Uma empresa recebe mensagens de voz de clientes. Algumas tratam de vendas, outras de dificuldades técnicas e outras pedem expressamente um atendente.
Com um modelo que aceite áudio diretamente, como o Gemini Decision 1, o sistema pode enviar a gravação e avaliar:
- O cliente está solicitando atendimento humano?
- Está relatando uma interrupção do serviço?
- Quer informações para contratar?
- Há informação suficiente para identificar o assunto?
Por exemplo, ao receber “meu site está fora do ar e preciso falar com alguém”, o fluxo pode encaminhar a mensagem para suporte e destacar o relato de indisponibilidade.
Se a gravação estiver incompreensível ou o assunto permanecer incerto, o sistema pede esclarecimento.
Não é necessário gerar uma resposta longa para decidir o encaminhamento. Se a empresa também quiser uma transcrição ou uma resposta personalizada, essas serão tarefas adicionais, executadas por componentes próprios.
3. Priorizar oportunidades comerciais pelas mensagens recebidas
Um formulário de contato recebe três solicitações:
- Quero saber quanto custa um site.
- Preciso de uma loja virtual integrada ao meu estoque e pretendo lançar no próximo mês.
- Vocês oferecem suporte para minha conta de e-mail?
Um modelo de decisão pode avaliar separadamente:
- Qual serviço a pessoa procura?
- Existe um prazo explícito?
- A mensagem descreve uma necessidade concreta?
- É uma oportunidade comercial ou uma solicitação de suporte?
O código combina esses resultados com dados objetivos, como região atendida, disponibilidade da equipe e situação do cliente.
A segunda mensagem pode receber prioridade comercial por apresentar escopo e prazo. A terceira segue para atendimento. A primeira pode receber uma solicitação padronizada de informações adicionais.
Essa avaliação deve considerar o que foi efetivamente informado. O modelo não precisa adivinhar orçamento ou intenção de compra para organizar melhor a fila.
O que esses exemplos têm em comum?
Em todos eles, a aplicação fornece uma entrada e faz perguntas pequenas, com resultados que podem orientar um fluxo.
A economia ganha relevância quando essas avaliações se repetem: fotos de catálogo, mensagens de voz, capturas de tela ou contatos comerciais. Em vez de gerar uma análise escrita a cada ocorrência, o sistema recebe os valores necessários para continuar o processo.
O uso de imagem, áudio ou vídeo também altera o consumo e precisa entrar no cálculo. A comparação deve considerar a entrada real e a qualidade obtida em cada tarefa.
Para que essas aplicações funcionem bem, é preciso formular perguntas claras e definir como o sistema deve lidar com resultados incertos.
Como formular perguntas melhores
Perguntas amplas misturam critérios e dificultam o controle do resultado.
Em vez de “este pedido deve ser aprovado?”, pode ser melhor avaliar separadamente se o documento está legível e se contém determinada informação. O código combina essas avaliações com verificações objetivas, como datas e limites de valor.
Também convém incluir uma opção de saída. Se as únicas alternativas forem financeiro, suporte e vendas, uma pergunta sobre previsão do tempo poderá ser encaixada indevidamente em uma delas. “Outros” ou “fora do escopo” permite representar esse caso.
Outro cuidado é a interpretação dos números. Probabilidade de “sim” e confiança não são sinônimos. Uma probabilidade baixa de “sim” pode representar uma avaliação firme de que a resposta é “não”. O significado dos campos depende da API.
Os limites para processamento automático precisam ser testados com exemplos reais. Um número alto, isoladamente, não garante acerto.
O que é RAG e onde entram os embeddings?
RAG é a sigla de Retrieval-Augmented Generation, geralmente traduzida como geração aumentada por recuperação.
Em um assistente de suporte, significa buscar informações na documentação e fornecê-las ao modelo que escreverá a resposta. A base pode conter manuais, artigos, políticas e perguntas frequentes.
Uma maneira de realizar essa busca utiliza embeddings: representações numéricas que permitem comparar a proximidade de significado entre conteúdos.
Assim, uma pergunta como “não consigo entrar na minha conta” pode encontrar um trecho sobre “problemas de acesso”, mesmo sem repetir exatamente as mesmas palavras. Embeddings permitem esse tipo de busca semântica.
A busca também pode usar palavras-chave ou combinar abordagens. RAG não exige obrigatoriamente embeddings.
Embeddings e modelos de decisão cumprem papéis diferentes
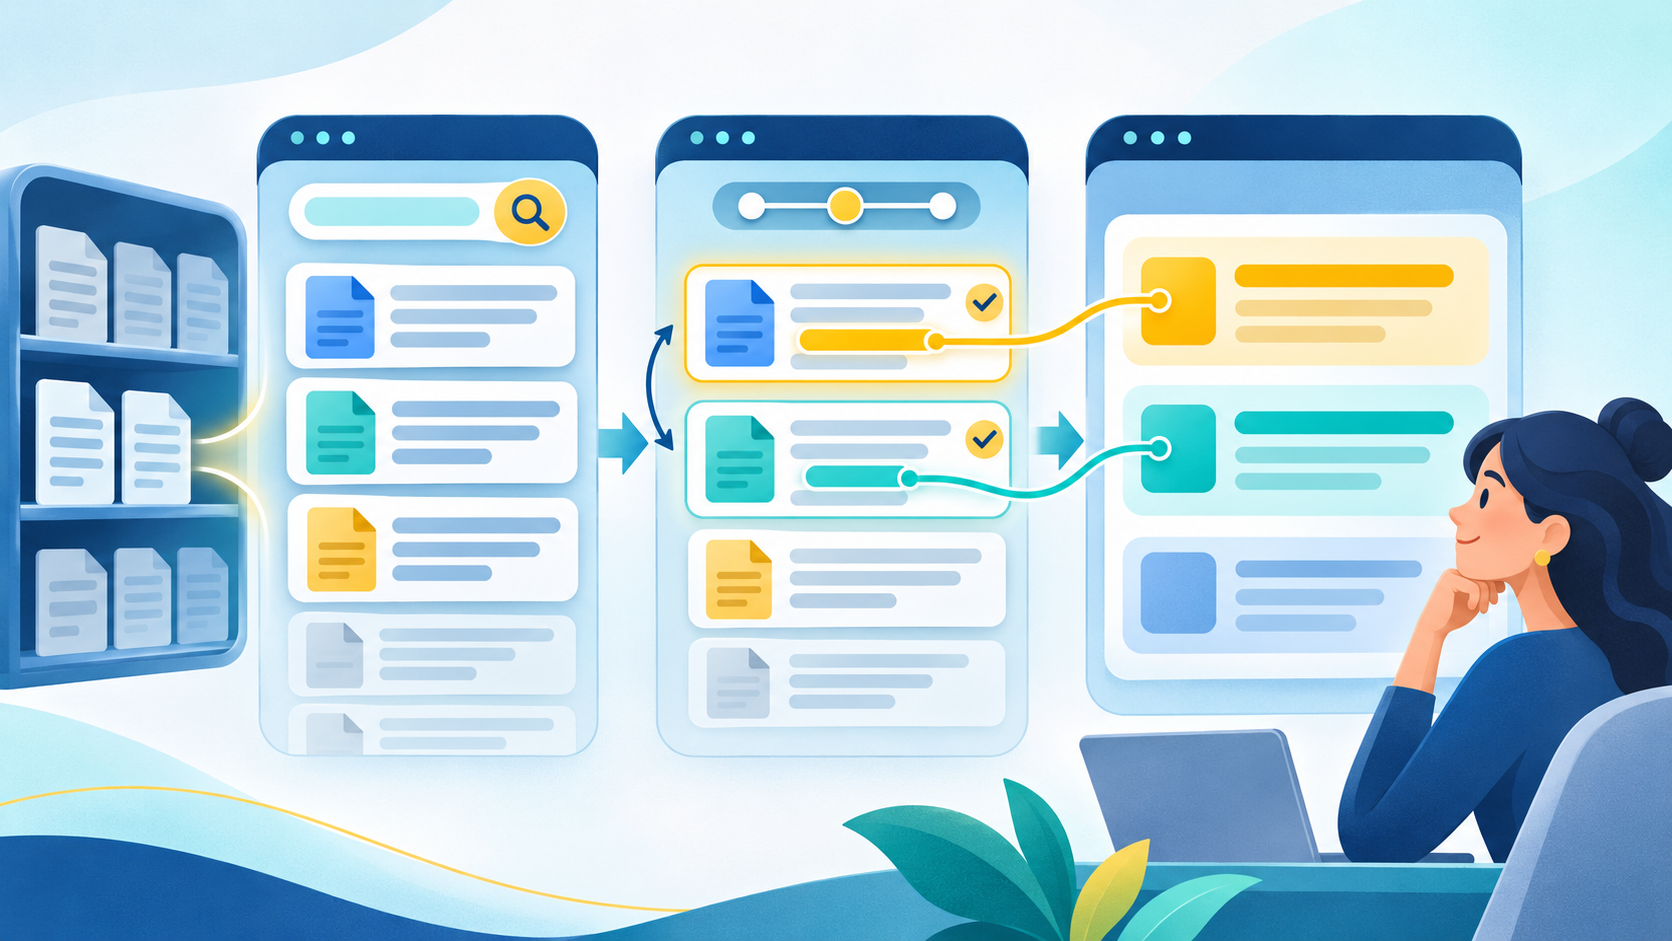
Na arquitetura que estamos discutindo, os embeddings ajudam a encontrar candidatos. O modelo de decisão avalia os candidatos recuperados segundo a pergunta e os critérios fornecidos.
| Componente | Papel | Pergunta que ajuda a responder |
|---|---|---|
| Embeddings e busca vetorial | Recuperar conteúdos próximos em significado. | Quais trechos tratam deste assunto? |
| Modelo de decisão | Filtrar ou pontuar os candidatos. | Este trecho ajuda a responder neste contexto? |
| LLM generativo | Elaborar a resposta usando os selecionados. | Como apresentar a orientação ao usuário? |
Uma página pode tratar do assunto correto e ainda assim não servir para aquela situação: pode abordar outro aplicativo, outra versão ou apenas descrever o problema sem apresentar uma solução.
O modelo de decisão pode ajudar a fazer essa avaliação. Porém, precisa receber os critérios e as evidências necessárias. Não descobrirá sozinho qual versão o cliente utiliza.
Também não recupera um documento que ficou fora da busca inicial. A qualidade dessa primeira seleção continua essencial.
Como funciona a combinação de modelos de decisão com RAG?
Vamos acompanhar um exemplo: “Como configurar meu e-mail no celular?”
Primeiro, o sistema precisa identificar o aplicativo usado. Se essa informação não estiver disponível, poderá solicitá-la.
Suponha que o usuário informe Gmail para Android. A busca recupera instruções atuais, uma página antiga, um tutorial para outro aplicativo e uma descrição comercial do serviço.
O código pode filtrar documentos por aplicativo e versão, quando esses campos estiverem registrados. Depois, o modelo de decisão recebe os trechos restantes e avalia questões como:
- O trecho apresenta passos de configuração?
- Esses passos atendem ao aplicativo informado?
- O conteúdo ajuda diretamente a responder à pergunta?
Com essas avaliações, o sistema pode filtrar os trechos encontrados ou reorganizá-los conforme sua relevância para a pergunta. Essa reordenação é chamada de reranking.
Já existem modelos especializados nessa tarefa, como os da família Rerank, da Cohere. Um modelo de decisão também pode fornecer avaliações para orientar essa reordenação, considerando critérios definidos pela aplicação, como a utilidade do trecho para responder à pergunta e sua adequação ao contexto informado.
A escolha entre essas alternativas deve considerar a qualidade da seleção, o custo e o tempo de processamento, medidos com perguntas e documentos representativos do uso real.
Finalmente, o LLM recebe os trechos selecionados e escreve a orientação, com referências aos documentos utilizados.
Se nenhum trecho oferecer base suficiente, o fluxo pode buscar mais informações, pedir esclarecimentos ou encaminhar para atendimento.
Essa combinação reduz o custo do RAG?
Pode reduzir, mas acrescentar uma avaliação também tem custo.
Imagine que a busca retorne 20 trechos e que a seleção identifique quatro como suficientes. Enviar esses quatro ao LLM pode diminuir o volume de entrada na etapa de geração.
Esse é um cenário ilustrativo. A economia efetiva depende do tamanho dos trechos, do preço dos modelos e do trabalho necessário para avaliá-los.
Existe ainda uma diferença relevante na cobrança: os embeddings dos documentos normalmente são calculados na preparação da base e reaproveitados. A avaliação de relevância costuma ser executada para cada nova pergunta. Portanto, comparar apenas o preço por milhão de tokens não revela o custo completo de cada etapa.
Antes de adotar a combinação, vale medir o gasto total por pergunta, o tempo de resposta e a qualidade da resposta final. Selecionar melhor os documentos ajuda, mas não garante que o texto gerado estará correto.
Para começar, escolha uma tarefa delimitada e reúna exemplos com respostas conhecidas. Compare o fluxo atual com a nova alternativa. Essa avaliação mostrará onde o modelo de decisão entrega uma vantagem concreta: classificar mais barato, selecionar contexto com maior precisão ou reduzir o tempo de uma automação.
Em um assistente de suporte, a divisão pode ficar assim:
- o código aplica regras e permissões;
- a busca encontra documentos ou trechos;
- o modelo de decisão avalia sua utilidade;
- o LLM escreve a resposta com base nas informações selecionadas.
Cada componente assume uma tarefa que pode ser medida e melhorada.
Posts recentes
COMPARTILHE
Se você gostou deste artigo, ajude a compartilhar este conteúdo.